 Serhii Lypii
De vraag Perplexity vs ChatGPT research krijg ik minstens één keer per week van klanten die research delegeren aan AI en de output moeten kunnen verantwoorden aan hun opdrachtgever of team. Het eerlijke antwoord is niet “tool X wint”, maar “welke tool wint per taak, en hoe controleer je de output voordat je hem gebruikt”. Perplexity Pro haalt 92 procent factual accuracy op real-time queries in onafhankelijke benchmark-tests 2026 op real-time query-nauwkeurigheid, tegenover 87 procent voor ChatGPT met browsing aan. Tegelijk laat de Tow Center-studie (Columbia Journalism Review, maart 2025) zien dat Perplexity nog altijd 37 procent van de citations misattribueert: het laagste van acht geteste tools, maar nog altijd meer dan 1 op de 3. Dit artikel loopt zes research-taken langs en zegt per taak welke tool je kiest.
Perplexity vs ChatGPT research in één tabel
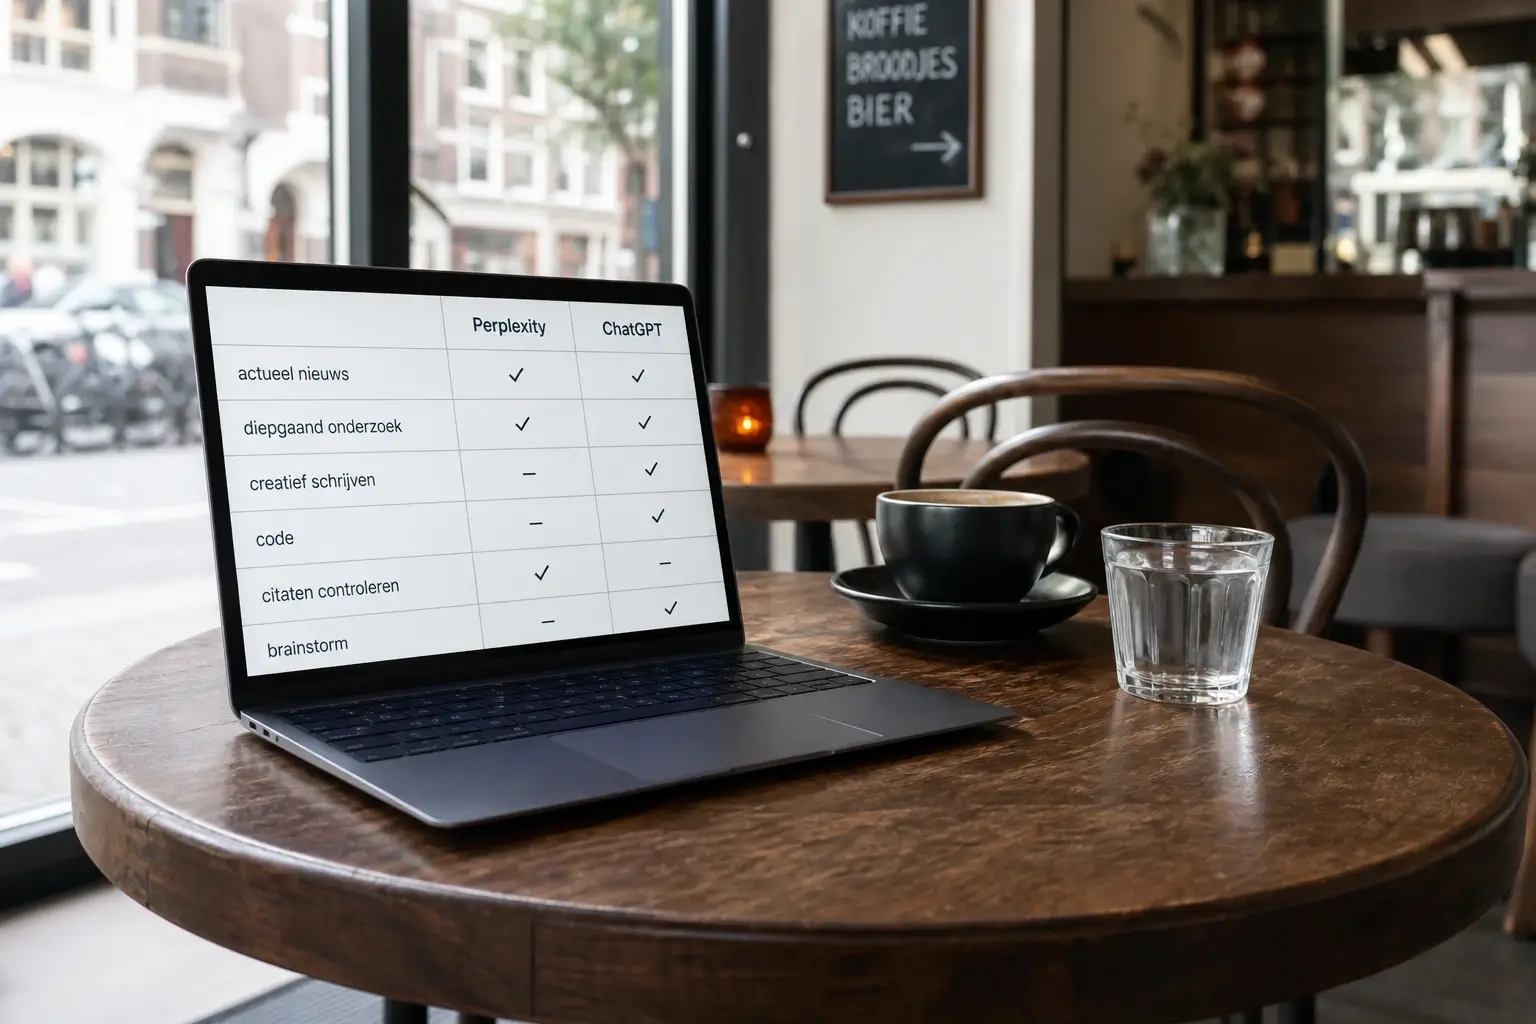
| Taak | Perplexity Pro | ChatGPT (Deep Research) | Winnaar | Caveat | |—|—|—|—|—| | Actueel nieuws / snel feit | Sterk | Redelijk | Perplexity | Bron altijd handmatig openen | | Diepe multi-source synthese | Redelijk | Sterk | ChatGPT | 10–40 min looptijd | | Juridische bronnen (EU/NL) | Redelijk | Redelijk | Gelijkspel | Beide missen NL-specifiek | | Cijfers / statistieken | Sterk | Redelijk | Perplexity | Getal-hallucinatie blijft mogelijk | | Academisch peer-reviewed | Redelijk | Redelijk | Gelijkspel | Google Scholar of Semantic Scholar erbij | | Concurrentie / SERP-intel | Redelijk | Redelijk | Gelijkspel | Ahrefs/Semrush blijft nodig |
Kern: geen algemene winnaar. De praktische workflow is Perplexity voor bronverzameling en factchecks, Claude of ChatGPT voor synthese, mens voor eindredactie.
Zes onderzoekstaken vergeleken
1. Actueel nieuws en snelle feit-checks
Perplexity Pro heeft real-time web-toegang standaard aan, en levert per antwoord gemiddeld 21,9 citations (Tow Center 2025 meting, Columbia Journalism Review, maart 2025). ChatGPT met browsing aan levert ongeveer 10,4 citations per antwoord. Voor snelle checks (“wat is de status van AI Act artikel 50 handhaving”) is Perplexity sneller en directer geciteerd.
Caveat: Perplexity’s Sonar-model kan tijdens piektijden minder consistent zijn dan de betaalde Pro-tier met Claude of GPT als reasoning-model. Test binnen jouw abonnement welke variant je krijgt.
2. Diepe multi-source synthese (Deep Research modes)
Voor lange multi-bron rapporten (30+ bronnen, 8–15 pagina’s output) is Deep Research de gedeelde categorie. ChatGPT Deep Research (looptijd 10–40 minuten) en Claude Research (looptijd 5–20 minuten) leveren strakkere synthese dan Perplexity Deep Research, die bronnen vaker citeert maar minder diepgaand analyseert.
Voor een marktrapport of concurrentie-scan: ChatGPT of Claude. Voor een quick-hit “welke 15 bronnen bestaan er over X”: Perplexity.
3. Juridische en regulatory bronnen
Beide tools missen consistent Nederlandse jurisprudentie en EU-secondary-legislation. Perplexity vindt eerder EUR-Lex en Europese Commissie-persberichten, ChatGPT vindt eerder AP.nl-guidance en Nederlandse blog-analyses. Combinatie geeft beste dekking.
Voor concrete AVG- en AI Act-vragen: bron altijd handmatig openen op eur-lex.europa.eu, autoriteitpersoonsgegevens.nl of digital-strategy.ec.europa.eu. En verwijzing naar een jurist blijft de norm voor toepassing.
4. Cijfers en statistieken (financieel, marktonderzoek)
Perplexity is sneller bij het vinden van de originele bron van een cijfer (rapport-URL, jaartal, methodologie). ChatGPT parafraseert vaker een cijfer zonder de primaire bron; met browsing aan wordt dat beter. Voor mkb-marktdata is Statista of CBS via Perplexity vaak het snelste pad.
AI-grens: getal-hallucinatie blijft mogelijk bij beide tools. Elk cijfer dat je publiceert of aan een klant meegeeft: bron openen, cijfer letterlijk terugvinden. Zonder die controle geen publicatie.
5. Academisch werk en peer-reviewed bronnen
Beide tools missen paywalled academic content. Google Scholar en Semantic Scholar zijn onmisbaar voor grondig academisch werk. Perplexity heeft een aparte “Academic” focus-modus die primair Semantic Scholar en arXiv doorzoekt; dat is een pluspunt voor onderzoekers.
Voor mkb-doelen (whitepapers, thought-leadership onderbouwen) is de Academic-modus van Perplexity een handige eerste stap, gevolgd door directe artikel-toegang.
6. Concurrentieanalyse en SERP-intelligence
Voor SERP-intelligence blijven Ahrefs, Semrush en Similarweb superieur; AI-tools missen historische ranking-data en keyword-volume. Wel is Perplexity handig voor snelle concurrentie-samenvattingen (“wat verkoopt X en tegen welke prijs op basis van hun eigen site en reviews”). ChatGPT met browsing kan hetzelfde, maar levert minder gestructureerde output.
Citation-controle: hoe je een AI-bron valideert in 60 seconden
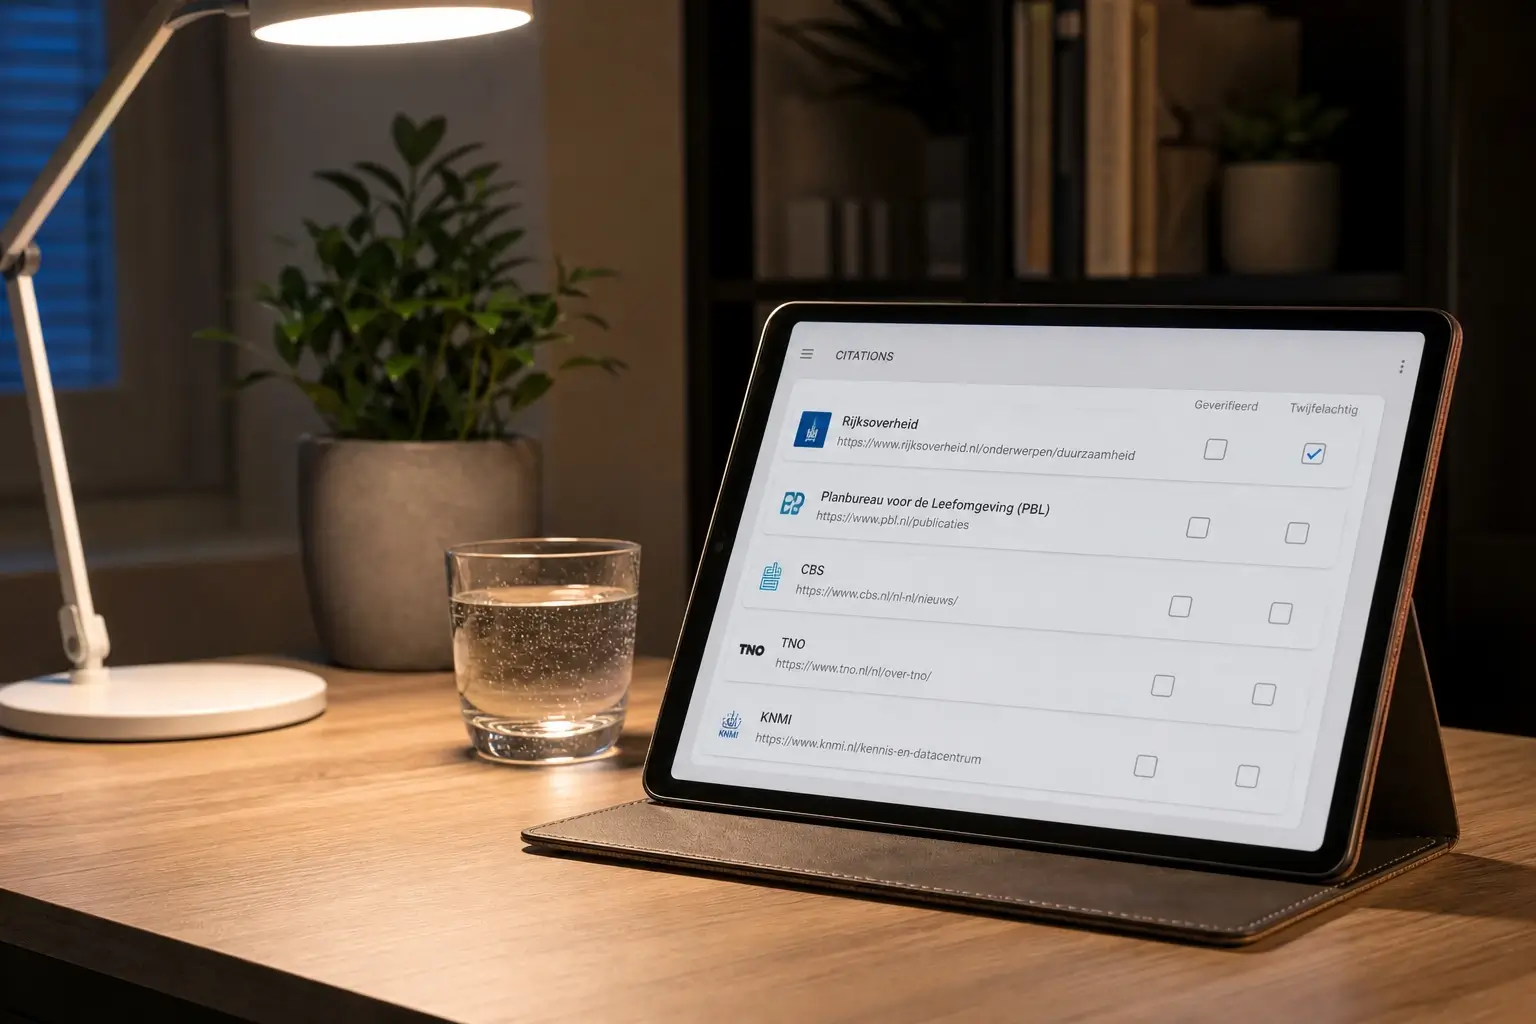
Elke AI-citation krijgt deze vijf-stappen-check:
- Klik de link. Bestaat de pagina? (Perplexity: 5–10% dode of onjuist geattribueerde links volgens Tow Center 2025, Columbia Journalism Review, maart 2025.)
- Zoek de exacte bewering met Ctrl+F. Staat hij letterlijk in de bron?
- Check publicatiedatum. Is de bron relevant voor 2026 of achterhaald?
- Check auteur/organisatie. Autoriteit-signalen aanwezig?
- Cross-check bij twijfel op een tweede, onafhankelijke bron.
Deze controle kost 60 tot 120 seconden per claim. Voor een rapport van 20 gecheckte claims: 30 tot 40 minuten. Zonder deze stap komt de misattributie-rate ongefilterd in jouw output terecht. Meer over de systematische aanpak staat in hallucinatie-controle workflow AI.
Wat de accuracy-cijfers wel en niet zeggen
De nummers 92% en 87% (onafhankelijke benchmark-tests 2026) meten factual accuracy op real-time queries in gecontroleerde tests, niet in jouw dagelijkse werk. Real-world performance schommelt op basis van (a) prompt-kwaliteit, (b) taal (Nederlandse queries scoren gemiddeld 5–10% lager dan Engelse), (c) domein (medische en juridische onderwerpen kennen hogere hallucinatie-rates).
Volgens de Tow Center Columbia-studie (cjr.org) haalden alle acht geteste AI-search tools misattributie-percentages tussen 37% (Perplexity, laagste) en meer dan 70% (bepaalde ChatGPT-search varianten). De “beste” tool zit dus nog steeds fout op 1 op de 3 citations. Human review is geen luxe.
Welk abonnement wanneer
Perplexity Pro (~€20/maand): individuele kenniswerker die dagelijks feit-checks en bron-verzameling doet. Perplexity Enterprise Pro biedt data-residency-opties (o.a. EU-processing) voor teams met gevoelige data.
ChatGPT Plus (~€23/maand): individuele gebruiker die vooral synthese en creatief werk doet. ChatGPT Team (~€27/gebruiker/maand) voor teams met gedeelde workspaces. ChatGPT Enterprise voor EU-data-processing en SOC 2 Type II.
Claude Pro (~€20/maand) of Team: sterk voor long-context (200k–1M tokens) analyses en coding. Voor deep research met citations vergelijkbaar met ChatGPT Deep Research; via AWS Bedrock EU-region beschikbaar voor bedrijven met EU-residency-eis.
Voor mkb-teams van 3–15 gebruikers: overweeg 1x Perplexity Pro (research-lead) + ChatGPT Team of Claude Team voor synthese en operationeel gebruik. Voor keuze per taak zie model routing AI per taak.
Direct contact: hoe Lypii dit aanpakt
Een research-workflow ontwerpen voor jouw team kost meestal 3 tot 6 uur: intake van 3–5 terugkerende research-vragen, mapping naar de juiste tool per taak, opstellen van prompt-templates en een citation-check protocol, plus een korte instructie voor het team. Tarief: 70 euro per uur voor advies, workflow-ontwerp en implementatie (tool-abonnementen inregelen, prompt-templates operationaliseren).
Wat ik niet doe: research-inhoudelijk werk voor jou uitvoeren, of bewijs leveren dat een specifieke tool “beter” is dan een andere in jouw exacte context. Ik lever de workflow en checks; jouw team past ze toe.
Voor de bijbehorende hallucinatie-controle: hallucinatie-controle workflow AI. Voor de bredere multi-model-keuze: model routing AI per taak.
Stuur me je twee tot drie meest voorkomende research-vragen. Ik reageer binnen 4 uur op werkdagen.