 Serhii Lypii
Een hallucinatie-controle workflow AI is geen luxe, het is de infrastructuur die de scheiding maakt tussen professioneel AI-gebruik en het publiceren van verzonnen bronnen. De Tow Center Columbia-studie (cjr.org) testte in 2025 acht AI-search-engines op citation-accuracy en vond misattributie-percentages tussen 37 procent (Perplexity, laagste) en meer dan 70 procent (bepaalde ChatGPT-search-varianten). Zelfs de “beste” tool zit fout op ongeveer 1 op de 3 citations. Hallucinaties zijn geen bug maar een eigenschap van large language models, en zonder controlelaag is elke publicatie een gok. Hieronder een 6-stappen-workflow per claim, plus prompts en tools die de foutmarge verkleinen, zonder te doen alsof die ooit nul wordt.
Waarom een hallucinatie-controle workflow AI onmisbaar is
LLM’s genereren waarschijnlijkheden, geen waarheid. Ze produceren tekst die klinkt als een correct antwoord, met dezelfde overtuigingskracht als een verkeerd antwoord. Voor interne brainstorms is dat prima; voor externe publicatie, klantcommunicatie, juridische documenten of financiële rapportages is het gevaarlijk. De praktische impact van een verzonnen bron in een klantrapport is niet abstract: het is een geloofwaardigheidsverlies dat niet snel terugkomt.
Zelfs de nieuwste modellen (Claude Opus 4.8, GPT-5.6, Gemini 3.1) hallucineren nog altijd: in benchmarks van Anthropic en OpenAI dalen de percentages, maar 3 tot 10 procent hallucinatie op factuele claims is nog steeds normaal (bron: model-cards Anthropic en OpenAI 2026). Voor een rapport met 50 factuele claims: statistisch 2 tot 5 hallucinaties, ongeacht welk model.
De workflow hieronder reduceert die foutmarge, maar elimineert hem niet. Voor juridische, medische en financiële content blijft menselijke expert-review verplicht.
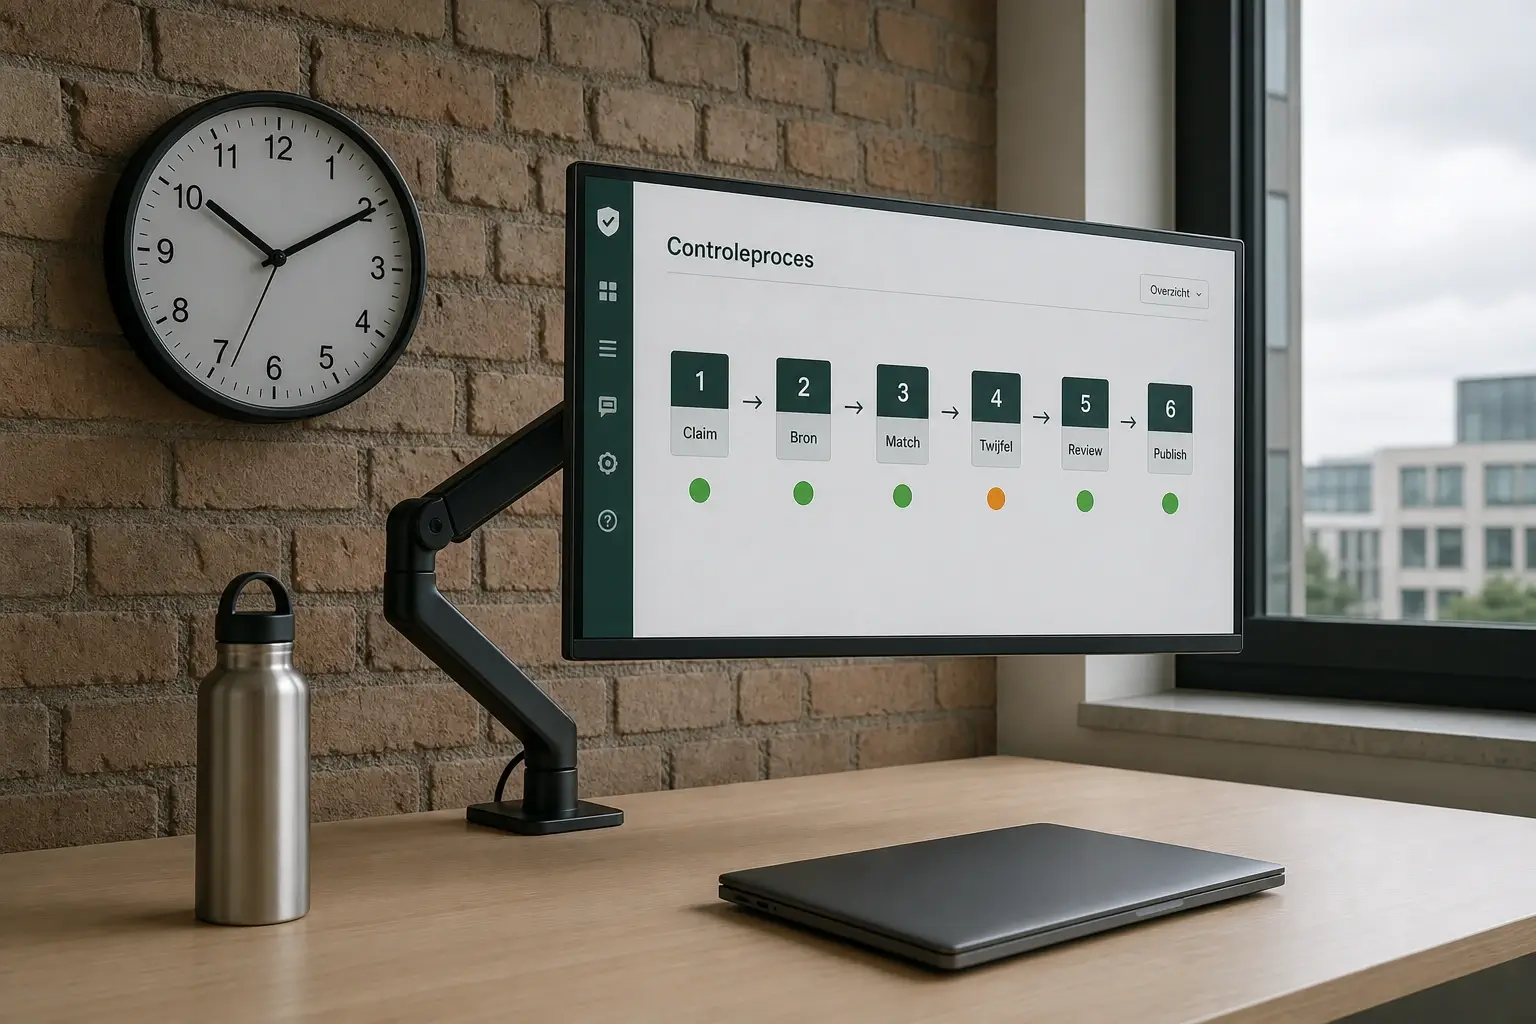
De 6 checks per claim
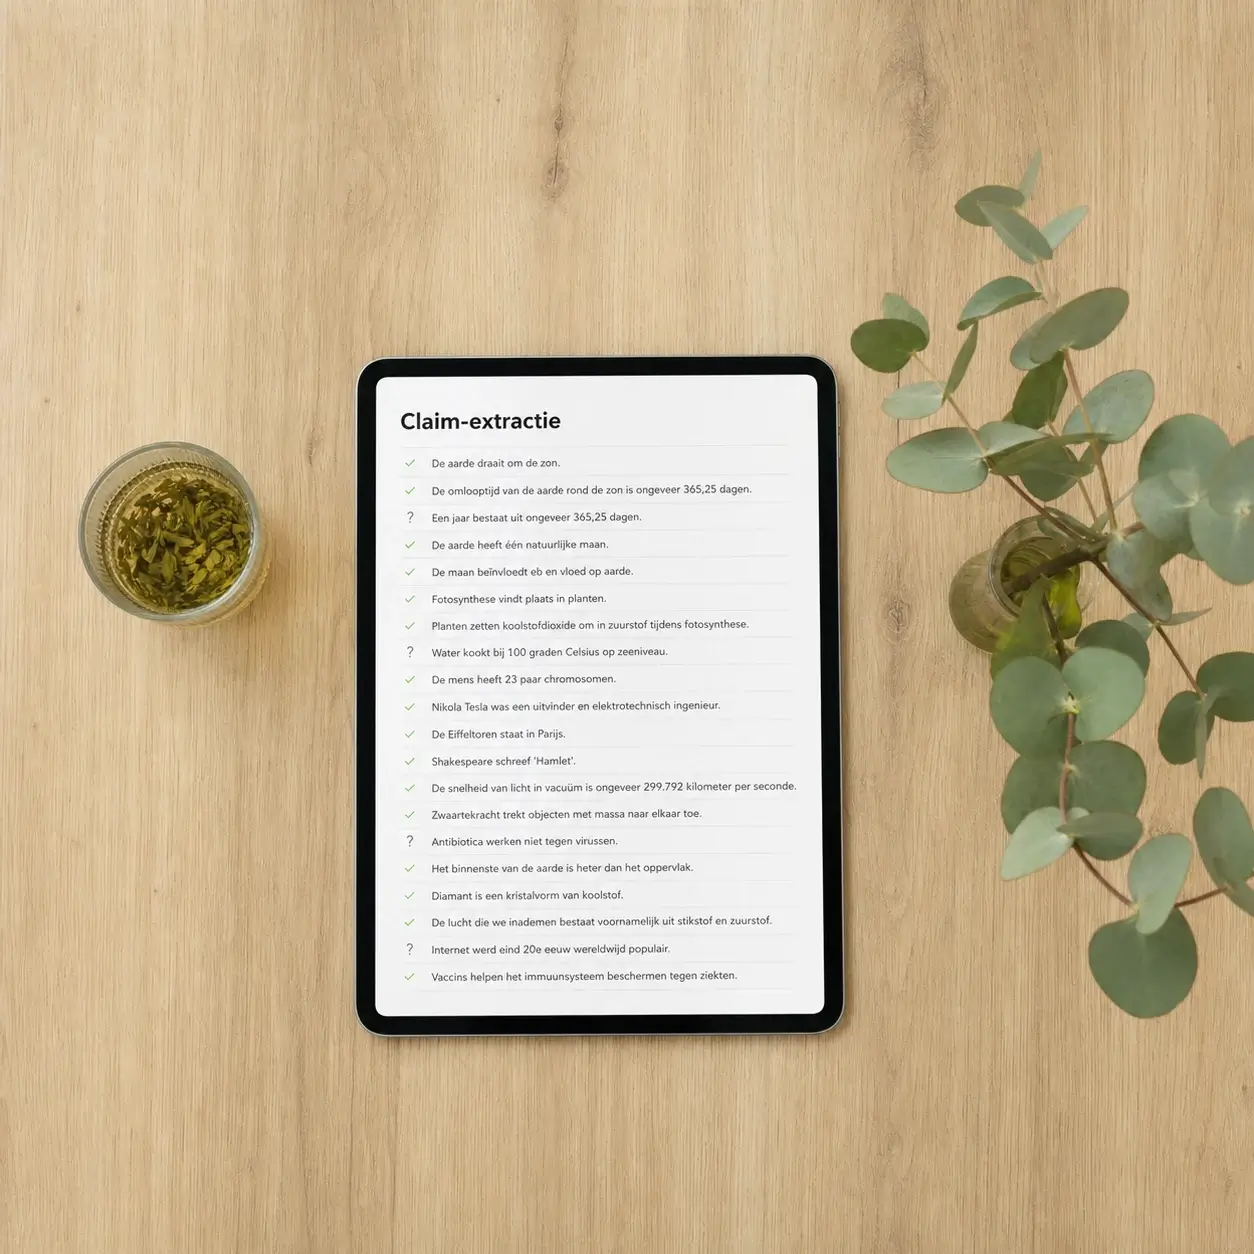
1. Claim-extractie: knip antwoord in atomaire beweringen
De eerste stap is de meest onderschatte. Een AI-alinea van 5 zinnen bevat vaak 8 tot 15 losse feitelijke beweringen. Wie de alinea als geheel factcheckt, mist de helft.
Werkinstructie: neem elke zin, splits hem in atomaire beweringen (één feit, één cijfer of één citaat per bewering). Voorbeeld:
“Volgens de Autoriteit Persoonsgegevens is de AVG in mei 2018 in werking getreden en gelden er sinds januari 2024 nieuwe boetes tot 4% wereldwijde omzet.”
Wordt:
- Claim 1: AVG is in mei 2018 in werking getreden.
- Claim 2: Sinds januari 2024 gelden er nieuwe boetes.
- Claim 3: Boetes gaan tot 4% wereldwijde omzet.
- Bron-attributie: Autoriteit Persoonsgegevens.
Nu is elk element apart controleerbaar. Tijdsindicatie: 30 tot 60 seconden per alinea.
2. Bron bestaat: URL/DOI verifieerbaar
Klik elke geciteerde URL. Verifieer:
- Bestaat de pagina (geen 404)?
- Is het de originele bron of een parafrase?
- Is de bron gezaghebbend (officiële instantie, primaire onderzoeker, gerenommeerd medium)?
- Voor academische claims: bestaat de DOI en leidt hij naar het juiste artikel?
Perplexity en ChatGPT genereren soms plausibel klinkende maar niet-bestaande URL’s (typisch bij hallucinatie). Tijdsindicatie: 20 tot 45 seconden per bron.
3. Bron zegt letterlijk wat de AI beweert
De meest voorkomende hallucinatie-vorm: bron bestaat, maar zegt iets anders dan de AI beweert. Gebruik Ctrl+F om de exacte bewering in de bron te vinden. Als de bewering er niet letterlijk in staat, controleer of parafrase mogelijk is (soms wél, soms niet). Bij twijfel: bewering verwerpen of afzwakken.
Tijdsindicatie: 30 tot 90 seconden per claim.
4. Bron is actueel en geldig voor NL/EU-context
Cijfers en beweringen hebben houdbaarheid. Een cijfer uit een 2019-rapport over “AI-adoptie in mkb” is achterhaald in 2026. Een US-benchmark voor “cybersecurity-incidenten” is soms niet 1-op-1 toepasbaar op de NL-context.
Check:
- Publicatiedatum van de bron.
- Geografische scope (VS, EU, NL).
- Sector-scope (algemeen, specifiek).
5. Getallen: cross-check op tweede onafhankelijke bron
Voor elke concrete statistiek of financieel getal: zoek een tweede, onafhankelijke bron die hetzelfde cijfer noemt. Twee bronnen die naar elkaar terugverwijzen tellen niet dubbel.
Voor kritieke rapporten (juridisch, financieel, medisch): drie onafhankelijke bronnen. Tijdsindicatie: 60 tot 180 seconden per getal.
6. Confidence-rating en escalatie
Markeer per claim: hoog / gemiddeld / laag zekerheid. Claims met “laag” gaan naar expert-review of worden verwijderd. Claims met “gemiddeld” krijgen expliciete disclaimer (“indicatief, verifieer voor eigen context”).
Voor extern gepubliceerde content: alle claims moeten “hoog” zijn na verificatie, of expliciet als indicatief gelabeld.
Prompts die het aantal hallucinaties verlagen
Prompt-engineering kan hallucinaties met 30 tot 60 procent verlagen zonder extra tools (bron: KnowHalu-paper arXiv 2404.02935 en Anthropic constitutional AI-onderzoek). Effectieve technieken:
- “Cite verifiable sources with working links and publication names.” Dwingt de AI om broninformatie op tafel te leggen die te controleren is.
- “Rate your confidence per claim: high/medium/low. Mark claims you cannot verify.” Model wordt eerlijker over eigen onzekerheid.
- “If information is not in your context or knowledge, say ‘ik weet het niet’.” Voorkomt gaten-vullen met plausibel klinkende onzin.
- Chain-of-Verification (CoVe): eerst antwoord genereren, dan het model laten opsommen welke feitelijke claims erin staan, dan per claim een verifiërende vraag laten stellen en zichzelf laten corrigeren.
CoVe-prompt in twee stappen:
- “Beantwoord de vraag: [X].”
- “Extraheer alle feitelijke beweringen uit je antwoord. Voor elke bewering: is deze verifieerbaar? Zo nee, verwijder of markeer.”
CoVe verhoogt latency (twee LLM-calls) maar verlaagt hallucinatie substantieel.
Tools die claim-per-claim controleren
Handmatige controle blijft de gouden standaard, maar er zijn tools die het proces versnellen:
- FactSentinel: claim-extractie en cross-check tegen web-bronnen. Nuttig voor eerste screening, geen vervanging voor expert-review.
- Verol: real-time hallucination checker met bron-visualisatie. Sterk voor teams die veel AI-content publiceren.
- TextSight: hallucinatie-detector met confidence-scoring per zin.
- Perplexity als cross-check: vraag Perplexity dezelfde vraag; als de bron-attribuut anders is dan wat je AI-tool aandroeg, is dat een rood vlaggetje.
AI-grens expliciet: deze tools verminderen hallucinaties, elimineren ze niet. Zelf zijn de detectie-tools ook LLM-gebaseerd en dus feilbaar. Reken op 70 tot 85 procent detectie van hallucinaties door tools, plus mens voor de rest.
Wanneer AI niet mag beslissen zonder mens
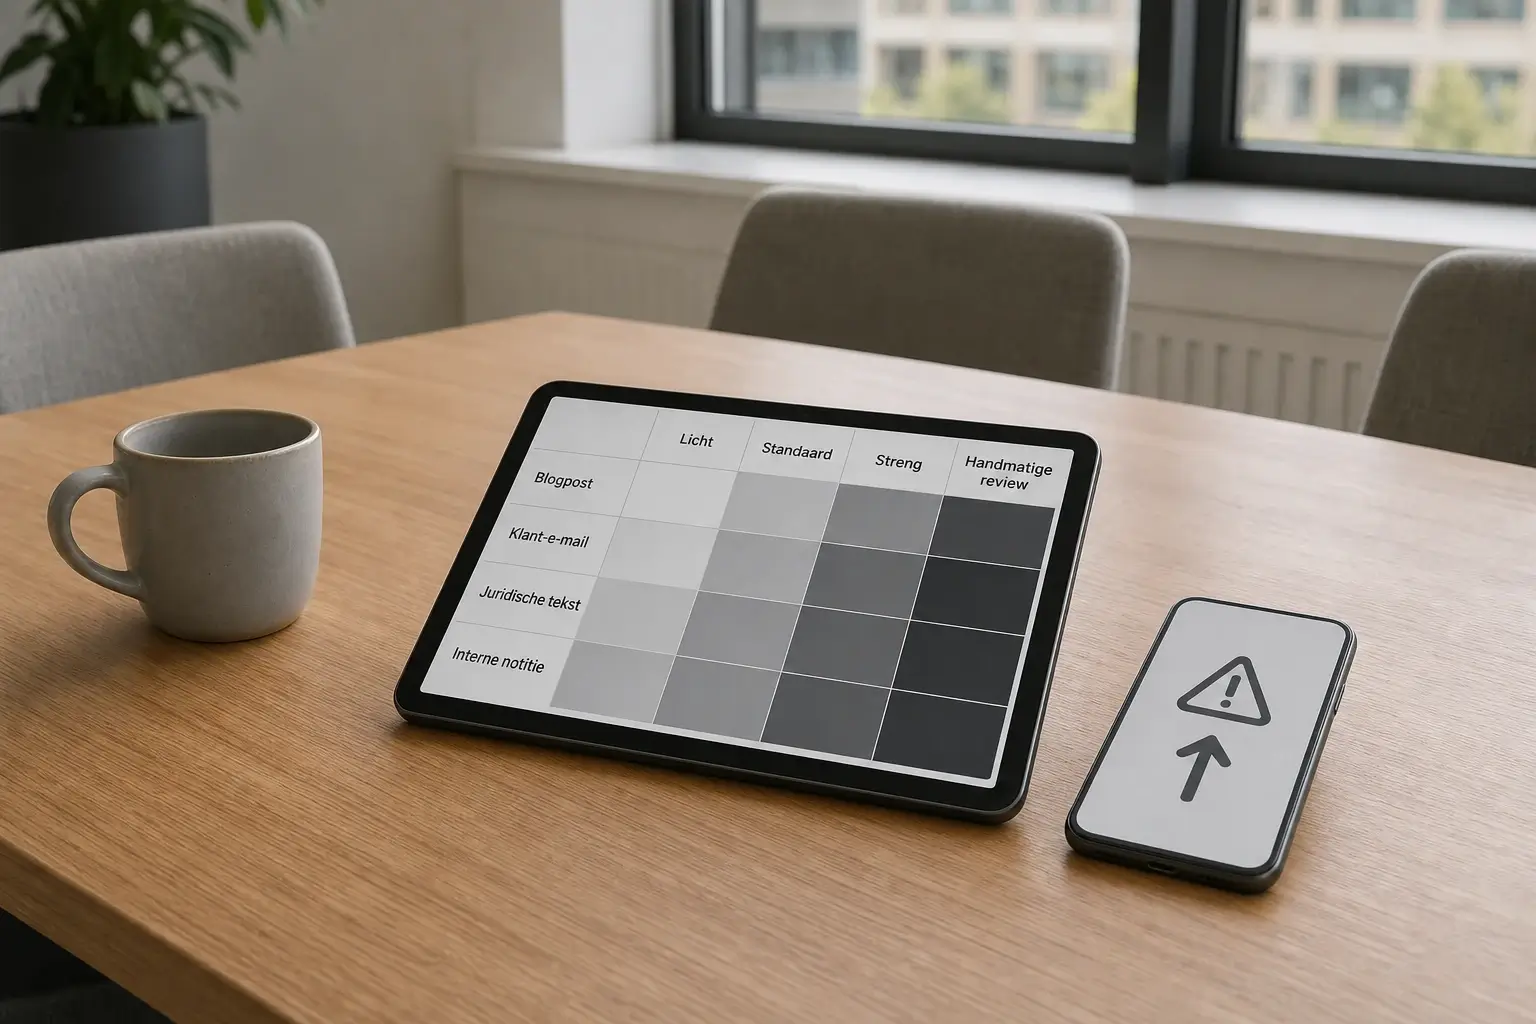
Escalatie-matrix per contenttype:
| Contenttype | Minimale check-diepte | Verantwoordelijke | |—|—|—| | Interne brainstorm | Basis (steekproef) | Auteur | | Blog, algemene content | Alle 6 checks per claim | Auteur + editor | | Klantrapport / offerte | Alle 6 checks + peer-review | Auteur + senior | | Juridisch / contractueel | Volledige review door jurist | Jurist verplicht | | Medisch / gezondheid | Review door arts of medisch specialist | Arts verplicht | | Financieel / fiscaal | Review door accountant of fiscalist | Expert verplicht |
Voor YMYL-content (Your Money or Your Life: financieel, medisch, juridisch): AI mag ondersteunen bij structuur en concept, mens neemt de eindverantwoordelijkheid.
Direct contact: hoe Lypii dit aanpakt
Een hallucinatie-controle workflow implementeren voor jouw team kost meestal 4 tot 8 uur: intake van de contenttypes die je produceert, mapping naar de escalatie-matrix, opstellen van prompt-templates met CoVe of eigen varianten, en een korte trainings-sessie voor het team over de 6 checks per claim. Tarief 70 euro per uur voor advies, workflow-ontwerp en implementatie (tools en templates operationaliseren, dashboards opzetten).
Wat ik niet doe: expert-review van medische, juridische of financiële content zelf. Dat is werk voor de betreffende expert. Ik zorg dat het proces staat en dat de escalatie op tijd gebeurt.
Voor de bijbehorende research-workflow: Perplexity vs ChatGPT research. Voor de refresh-uitvoering van bestaande content: AI content refresh oude blogs.
Stuur me een voorbeeld van AI-output die je publiceert (blog, rapport, klant-e-mail). Ik reageer binnen 4 uur op werkdagen.