 Serhii Lypii
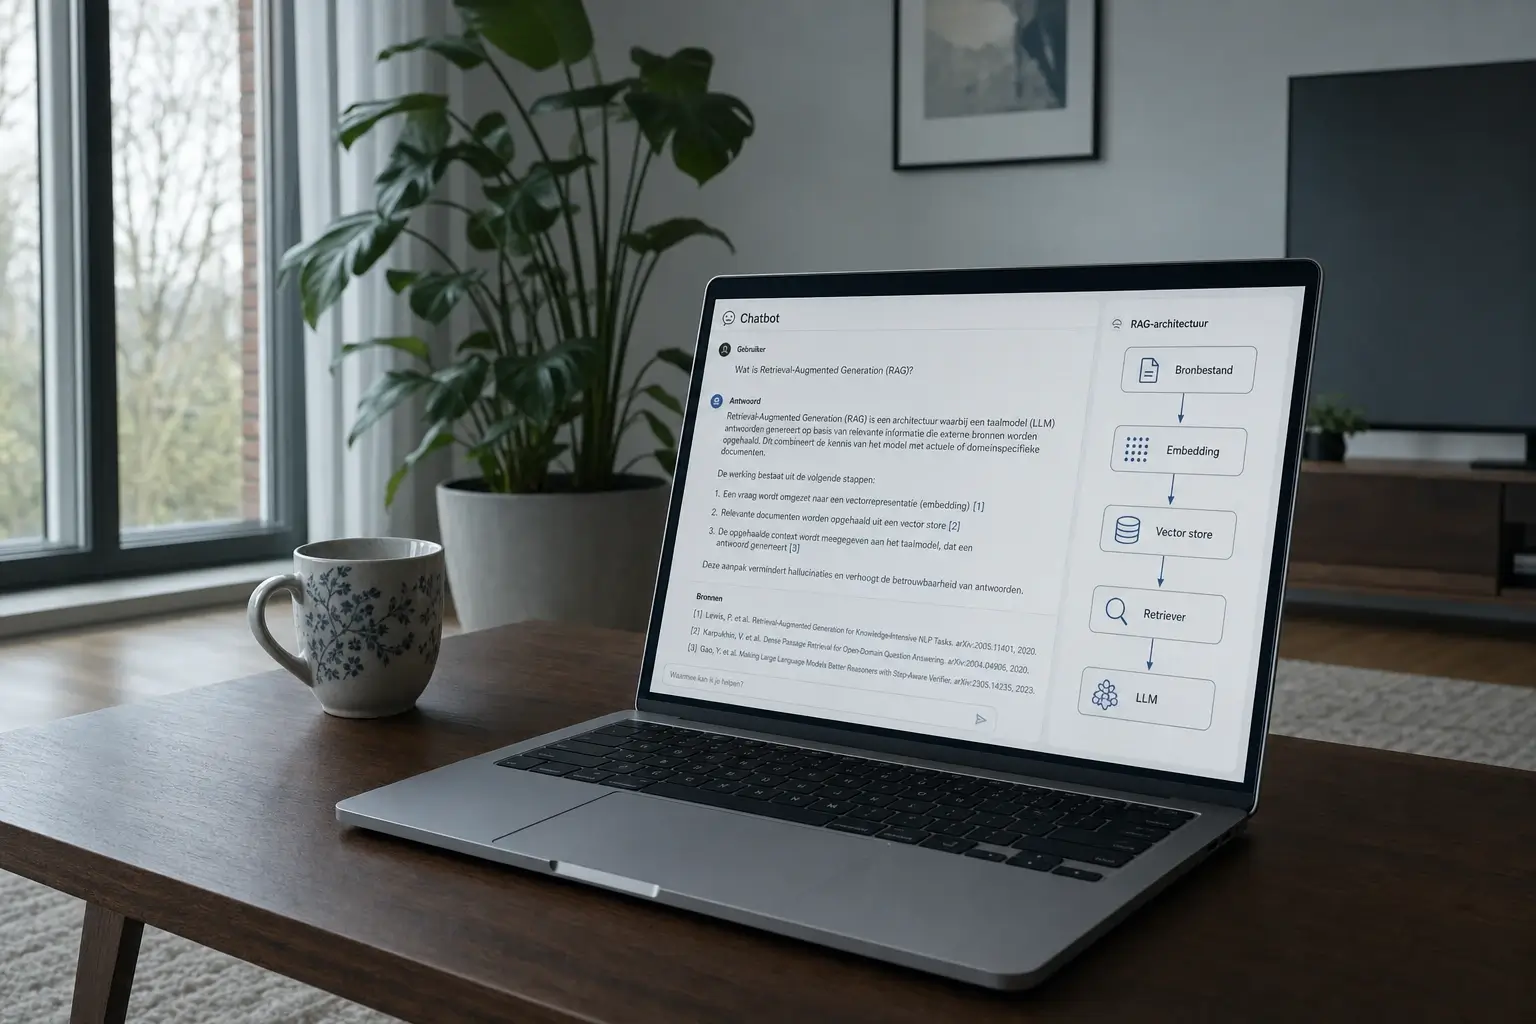
Wie een custom GPT bouwen klantvragen wil aanpakken, staat voor een bouwbeslissing die op techniek lijkt maar in werkelijkheid over traceerbaarheid gaat. Een RAG-chatbot (retrieval-augmented generation) laat het model antwoorden op jouw documenten zonder dat je hoeft te hertrainen; elk antwoord kan worden teruggevoerd naar de bron. Dat is niet alleen fijn voor klantvertrouwen: het is ook cruciaal onder de AI Act, waarvan artikel 50 (transparantie voor eindgebruikers) op 2 augustus 2026 in handhaving gaat en artikel 4 (AI-geletterdheid) sinds 2 februari 2025 van kracht is met handhaving vanaf 2 augustus 2026. Hieronder volgt een 8-stappen-plan met wat je technisch en juridisch nodig hebt, en waar de mens verplicht overneemt.
Dit artikel is geen juridisch advies. Voor de exacte AVG- en AI Act-tekst voor jouw use-case hoort een privacy-advocaat of jurist erbij, niet een technische blauwdruk.
Wanneer een custom GPT bouwen klantvragen echt zin heeft
Een custom GPT verdient zichzelf terug als er voldoende volume, herhaling en documenteerbaarheid is. Concrete signalen:
- 30+ klantvragen per week die uit een beperkte, stabiele kennisbank beantwoord kunnen worden.
- Antwoorden staan al in FAQ’s, handleidingen, offertes-templates of algemene voorwaarden.
- Support-team krijgt >50% dezelfde vraag terug (deflection-kandidaten).
- Menselijke fallback beschikbaar (chat, e-mail of telefoon) binnen redelijke responstijd.
Waar het minder werkt: hoogsensitieve gesprekken (medisch, financieel advies), complex maatwerk-offertes, of vragen die actuele voorraad/beschikbaarheid nodig hebben zonder API-integratie.
Waarom RAG en niet fine-tuning
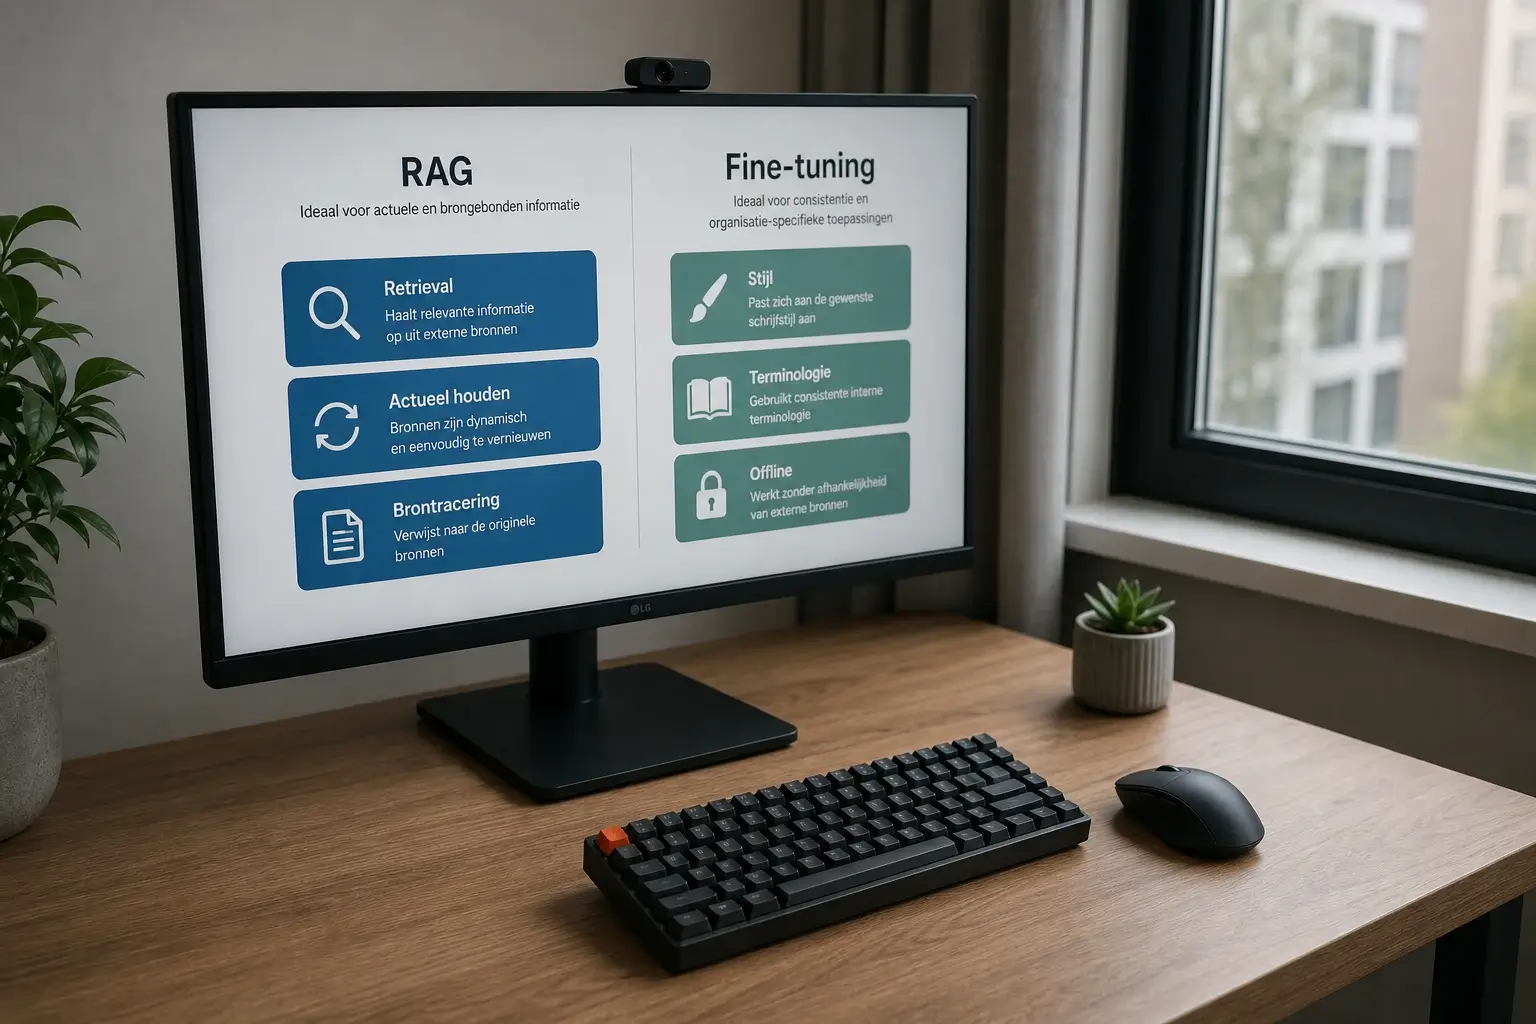
De keuze RAG vs fine-tuning is niet ideologisch, maar praktisch:
| Aspect | RAG | Fine-tuning | |—|—|—| | Kosten setup | €3.500–€9.000 | €8.000–€25.000+ | | Bron-traceerbaarheid | Ja, per antwoord | Nee | | Updatesnelheid | Direct (nieuw doc = nieuwe kennis) | Hertraining nodig | | Hallucinatie-risico | Lager | Hoger | | Tone-of-voice | Redelijk | Sterk | | AI Act-compliance | Makkelijker (traceerbaar) | Zwaarder |
Advies: RAG voor kennisbanken en klantvragen; fine-tuning alleen als je écht een merk-eigen tone-of-voice moet inbakken en RAG dat niet voldoende oplost.
De 8 stappen
1. Vraagclusters uit CRM/e-mail extraheren
Exporteer 3 tot 6 maanden support-tickets of e-mail-vragen. Cluster ze op onderwerp (verzending, retouren, prijs, technische specificatie, garantie). Bepaal per cluster het volume en de gemiddelde afhandeltijd. Dit is je deflection-kandidatenlijst; alles onder 5% volume kan eruit.
2. Bron-corpus: welke documenten in de kennisbank
Wat wél in het corpus: FAQ, productdocumentatie, handleidingen, algemene voorwaarden, retour- en verzendbeleid, veelgestelde support-antwoorden.
Wat expliciet niet: persoonsgegevens van klanten, salarisdata, contracten onder NDA, interne memo’s, prototype-documentatie die vertrouwelijk is. Elke bron krijgt een expliciete “wel/niet in bot”-label voor of hij op het corpus staat.
3. Chunking en embeddings kiezen
Splits documenten in chunks van 300 tot 800 tokens met 10 tot 15% overlap. Voor Nederlands en Engels: OpenAI text-embedding-3-large of Cohere multilingual v3. Voor volledig EU-hosted stack: Mistral Embed of BAAI/bge-m3 (open source) via Azure of Hugging Face EU-region.
Test op je eigen corpus met 20 representatieve vragen; embeddings-keuze is geen “zet aan en klaar”, verschillen tussen modellen zijn 5 tot 20% precisie op NL-teksten.
4. Retrieval-strategie (top-k, hybrid, reranker)
Standaard: hybrid search (BM25 sleutelwoord + vector similarity) + reranker (bijv. Cohere Rerank of Voyage AI). Deze combinatie verhoogt precisie met 15 tot 25% ten opzichte van pure vector search (bron: Cohere/Voyage AI benchmarks 2026). Top-k tussen 5 en 15 chunks retrieved, de reranker selecteert daarvan de 3 tot 5 meest relevante voor de LLM-prompt.
5. Prompt-scaffolding met bronnen-attributie
De system-prompt dwingt bron-nummering af. Voorbeeld:
“Beantwoord de vraag van de gebruiker uitsluitend op basis van de meegeleverde bronnen. Nummer bronnen als [1], [2], [3] in je antwoord. Als het antwoord niet in de bronnen staat, zeg dan letterlijk ‘ik weet het niet’ en bied menselijke escalatie aan via [link]. Verzin geen informatie.”
Deze scaffolding verlaagt hallucinatie substantieel en maakt de output verifieerbaar voor de eindgebruiker.
6. Guardrails en escalatie naar mens
Guardrails zijn de vangrails die voorkomen dat de bot uit de rails loopt:
- Onderwerp-filter: bot antwoordt niet op vragen buiten scope (politiek, medisch advies, concurrentievergelijking).
- Toxiciteit-check: bot herkent en de-escaleert scheldwoorden of dreigementen.
- Escalatie-trigger: bij “ik wil een mens spreken” of na twee onbevredigende antwoorden opent de bot een menselijk kanaal.
- Rate-limit: geen antwoord op 100+ vragen binnen 5 minuten vanuit één IP (misbruik-preventie).
7. AI Act artikel 50 transparantie inbouwen
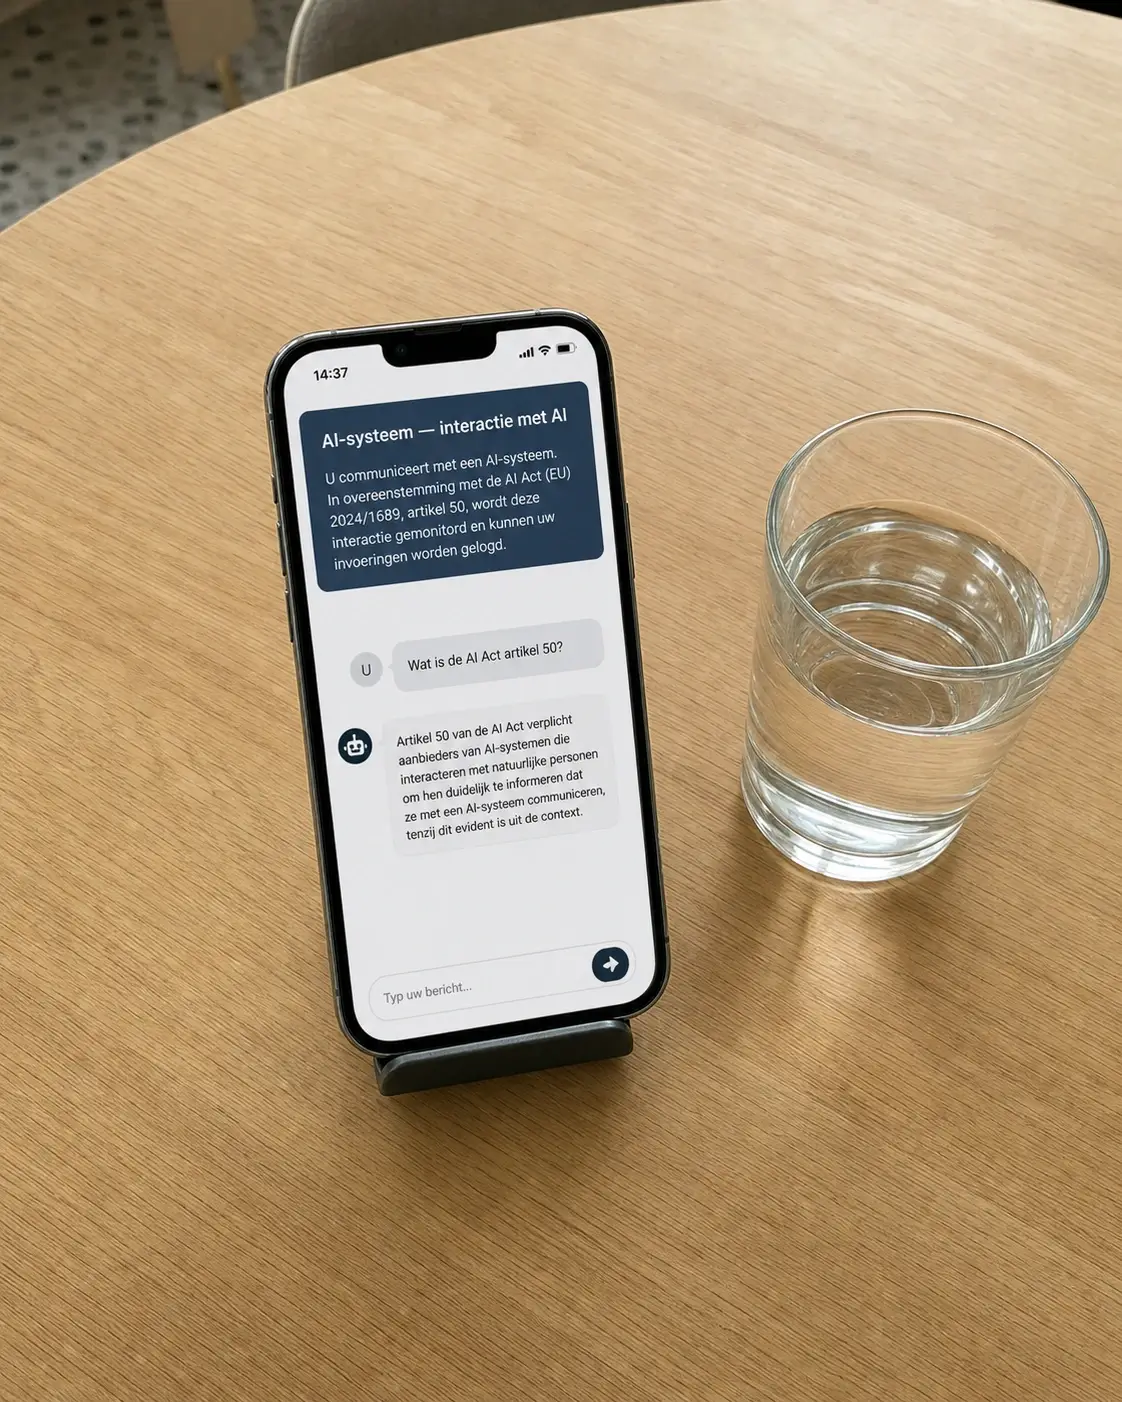
Vanaf 2 augustus 2026 moeten eindgebruikers weten dat ze met een AI-systeem interacteren, niet met een mens. Concrete inbouw voor een support-chatbot:
- Opening: banner of eerste bot-bericht: “Je chat met een AI-assistent. Kies [hier] voor een medewerker.”
- Footer op elke pagina met de chatbot: kleine tekst over AI-inzet met link naar privacy- en AI-verklaring.
- Log: alle gesprekken gearchiveerd (met AVG-conforme bewaarperiode) voor audit-doeleinden.
De uitzondering “duidelijk als AI herkenbaar” geldt niet automatisch voor mkb-supportchat; ga standaard uit van expliciete disclosure. De officiële tekst staat in Verordening (EU) 2024/1689 artikel 50 op EUR-Lex.
8. Meten: precisie, recall, deflection-ratio
Zonder metingen weet je niet of het werkt. Meet:
- Precisie: percentage bot-antwoorden dat inhoudelijk correct is (steekproef 50–100 antwoorden per maand, mens beoordeelt).
- Recall: percentage vragen waarop de bot antwoord kan geven (versus “ik weet het niet”-escalaties).
- Deflection-ratio: percentage gesprekken dat de bot volledig afhandelt zonder menselijke tussenkomst.
- Klanttevredenheid: korte thumbs-up/down per antwoord.
Realistische benchmarks eerste 3 maanden: precisie 80–90%, recall 60–75%, deflection 40–60%.
AI Act artikel 50: wat moet er zichtbaar zijn
Zoals hierboven: expliciete disclosure dat het om AI gaat, escalatiepad naar mens, en logging voor audit. De Europese Commissie (digital-strategy.ec.europa.eu/en/policies/regulatory-framework-ai) publiceert de handhavingsleidraden en gedelegeerde besluiten die de exacte invulling per use-case bepalen.
Voor de AI Act-compliance breder (art 4 AI-geletterdheid, art 6 risico-classificatie, art 50 transparantie): laat een privacy-advocaat of jurist met AI-expertise jouw specifieke setup beoordelen. Dit artikel geeft technische richting, geen juridisch advies. Meer context over AI Act voor mkb staat in AI Act checklist mkb 2026 en AI-geletterdheid artikel 4 mkb.
Kosten en tarieven
Standaard mkb-bouwset RAG-chatbot:
- Eenmalig bouwen: €3.500–€9.000 (afhankelijk van corpus-omvang, integraties en gewenste guardrails).
- Inference per maand: €50–€300 (afhankelijk van volume; 500 gesprekken/maand kost typisch €80–€150 aan LLM- en embedding-kosten).
- Onderhoud: 2–8 uur per maand voor corpus-updates, monitoring en fine-tuning van prompts.
AI-grens expliciet: RAG-chatbots halen retrieval-fouten (verkeerd chunk gepakt, verouderd document, ambigue vraag). Verwacht 5–15% foutmarge op complexe vragen zelfs bij goed getrainde systemen. Menselijke escalatie is niet optioneel. Voor cruciale klantbeslissingen (contracten, refunds boven een drempel, medisch advies) is de bot een filter en samenvatter, geen beslisser.
Bij Lypii: 70 euro per uur voor advies, architectuur en RAG-bouw met integratie. Voor volledige RAG-corpus-bouw en integratie in een bestaande site: raming meestal 40 tot 90 uur.
Direct contact: hoe Lypii dit aanpakt
Een RAG-blauwdruk maken kost meestal 6 tot 12 uur: intake van vraag-volume en kennisbank, corpus-selectie met wel/niet-labels, architectuur-keuze (embedding model, retrieval, LLM), AI Act-checklist en een eerste kosten- en timeline-raming. Tarief 70 euro per uur.
Implementatie zelf (bouw, integratie in je site of ticketsysteem, guardrails inregelen, transparantie-melding onder art 50, monitoring-dashboard) volgt op basis van de blauwdruk, tegen 70 euro per uur.
Wat ik niet doe: DPIA opstellen bij bijzondere persoonsgegevens in de corpus of gespreksdata, en juridische toetsing van AI Act-classificatie. Dat is werk voor een privacy-advocaat of DPO. Ik bouw de technische laag binnen de kaders die jij en je jurist afgesproken hebben.
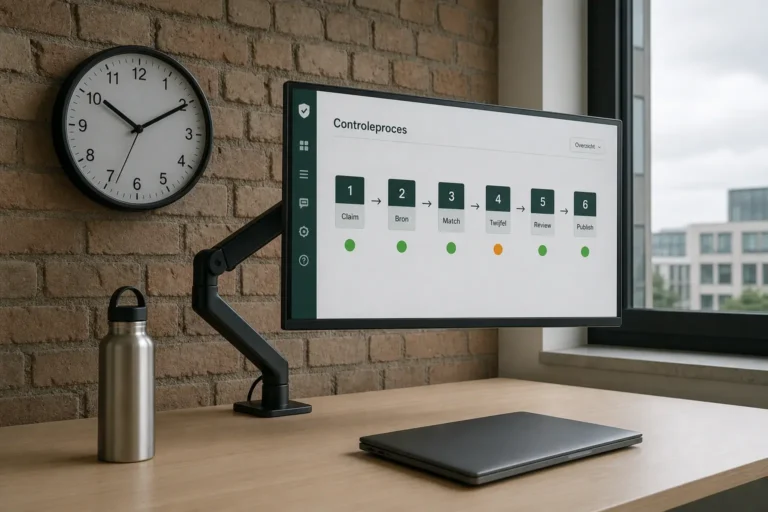
Voor volwassenheid rond hallucinaties in dit soort systemen: hallucinatie-controle workflow AI. Voor de bredere AI Act-context: AI Act checklist mkb 2026.
Stuur me de top 20 terugkerende klantvragen uit je mailbox of ticketsysteem. Ik reageer binnen 4 uur op werkdagen.
Wil je deze aanpak toepassen op je eigen dienstverleningssite, bekijk dan ook de gids over een lokale chatbot voor dienstverleners.