 Serhii Lypii
Met Ollama lokale LLM mkb haal je in een middag een privacy-vriendelijk alternatief voor ChatGPT binnen je eigen kantoormuren, voor de prijs van een goede workstation en een uur configuratie. In mijn ervaring is dit geen ChatGPT-vervanger, maar wél de juiste keuze voor mkb’ers met vertrouwelijke documenten, een DPO die scherp op dataflows let, of een team dat structureel binnen de EU wil blijven. Deze brief laat de hardware-eisen zien, benoemt welke modellen het beste Nederlands spreken in 2026, geeft een concreet 4-stappen Open WebUI-installatieplan, en zet Ollama eerlijk naast cloud-alternatieven.
Lokale LLM’s zijn qua ruwe intelligentie duidelijk minder scherp dan GPT-4o of Claude Sonnet. Wie dat verzwijgt verkoopt hardware, geen oplossing. Voor advies over model-keuze en use-case-scoring werk ik op 95 euro per uur; voor uitvoering (installatie, Open WebUI, RAG-basis) 70 euro per uur.
Ollama lokale LLM mkb: wanneer is lokaal beter dan cloud?
Er zijn drie scenario’s waarin lokaal in het mkb duidelijk beter uitpakt dan cloud-AI:
- Vertrouwelijke documenten die je juridisch of contractueel niet naar een US-cloud mag sturen (concept-contracten, personeelsdossiers, patiëntgegevens bij zorgpraktijken).
- Team van 6+ gebruikers waarbij de maandelijkse ChatGPT Team-kosten oplopen tot een niveau waar eenmalige hardware breaks-even komt binnen 24 maanden.
- Structurele batch-verwerking (documenten samenvatten, e-mails classificeren, notities structureren) waar API-kosten van cloud-modellen bij grote volumes tegenvallen.
Er zijn ook duidelijke situaties waarin cloud beter blijft:
- Complexe redenering, code-review, wiskundige analyse: 7B-modellen halen het niveau van GPT-4o niet.
- Wisselende gebruikers-load onder de 5 personen: cloud-abonnement is voordeliger dan hardware-investering.
- Behoefte aan live web-toegang, geavanceerde plug-ins, of multi-modale input (beeld, audio) zonder extra tooling.
De praktische stelregel: voor documenten die “eigenlijk niet in de cloud zouden mogen” is Ollama de rustige keuze. Voor algemene productiviteit blijft ChatGPT of Claude vaak de betere prijs-kwaliteit-verhouding.
Hardware-eisen concreet (7B, 8B, 14B)
De hardware bepaalt welk model comfortabel draait. Ondergrenzen versus comfortabele werkomgeving:
- 7B-model in Q4_K_M quantisatie: minimum 8 GB RAM of VRAM. Werkt, maar traag bij lange context.
- 7B/8B comfortabel: 16 GB RAM (of unified memory op Apple Silicon). Prima voor dagelijkse taken.
- 14B: 24 tot 32 GB VRAM aanbevolen. Substantieel scherpere output op complexere taken.
- Apple Silicon M2/M3/M4 met 16 GB unified: draait Mistral 7B en Llama 3.2 7B soepel. M-serie met 32 GB doet 14B-modellen comfortabel.
- Windows/Linux workstation: NVIDIA RTX 3060 12 GB is de praktische ondergrens voor comfort; RTX 4070 of 4080 voor 14B-werk.
Budget-indicatie voor mkb-workstation:
- Mac mini M4 Pro 24 GB: rond €1.700 tot €2.100.
- Zelfbouw Windows-workstation met RTX 4070: €2.000 tot €2.800.
- Refurbished workstation met RTX 3060 12 GB: vanaf €1.200.
Dit is een eenmalige investering; energieverbruik bij actief gebruik is 60 tot 250 watt afhankelijk van model en hardware.
Modellen die het beste Nederlands spreken in 2026
De officiële Ollama-modelbibliotheek (ollama.com/library) heeft in juli 2026 meer dan 100 modellen. Voor mkb-Nederlands zijn dit de praktische kandidaten:
- Qwen 2.5 (7B en 14B): op dit moment de sterkste NL-prestatie in het 7B/14B-segment. Instructie-begrip goed, feit-hallucinaties nog aanwezig maar minder dan Llama.
- Mistral 7B v0.3: solide Nederlands, snel op bescheiden hardware. Sterke keus voor productiviteit.
- Llama 3.2 7B: brede taalcapaciteit, iets minder scherp op NL-nuance dan Qwen.
- Phi-3 mini (~3.8B): klein, snel, matig Nederlands. Geschikt voor structuur-taken (classificeren, samenvatten) op zwakke hardware.
Verifieer altijd zelf met je eigen prompts uit je eigen praktijk. Publieke benchmark-scores zeggen weinig over hoe een model met jouw specifieke jargon of documenten omgaat.
Open WebUI installatie in 4 stappen
Open WebUI (github.com/open-webui/open-webui) is een gebruiksvriendelijke interface die op ChatGPT lijkt en verbindt via de Ollama-API. Vier stappen om het draaiend te krijgen op Windows, macOS of Linux:
- Installeer Ollama vanaf ollama.com voor je besturingssysteem. Na installatie draait de Ollama-service op poort 11434.
- Trek een model binnen via de terminal:
ollama pull qwen2.5:7b(of mistral, llama3.2). De download is 4 tot 9 GB. - Installeer Open WebUI via Docker:
docker run -d -p 3000:8080 --add-host=host.docker.internal:host-gateway -v open-webui:/app/backend/data --name open-webui ghcr.io/open-webui/open-webui:main. Of Python-installatie voor wie geen Docker wil. - Open http://localhost:3000 in de browser, maak een admin-account aan, selecteer het model, klaar.
Voor multi-user gebruik: Open WebUI ondersteunt gebruikers-accounts en toegangscontrole. Voor teams >5 gebruikers is een dedicated workstation met LAN-toegang een efficiëntere setup dan individuele installaties.
Use cases voor mkb (5 concrete voorbeelden)
Vijf toepassingen die in de praktijk direct waarde leveren:
- Concept-mails formuleren met bedrijfsgevoelige data. Bij offertes, klachten of interne memo’s waar de content niet in een cloud mag.
- Interne kennisbank-QA met RAG (retrieval-augmented generation) via LlamaIndex of Open WebUI’s ingebouwde documenten-functie. Werkinstructies, procedures, historische e-mails doorzoekbaar.
- Contract-samenvattingen. Concept-contracten van leveranciers of klanten samenvatten voor eerste beoordeling, zonder de tekst naar OpenAI of Anthropic te sturen.
- Interne beleidsteksten herformuleren. Van juridisch-Nederlands naar B1/B2-Nederlands voor medewerker-communicatie.
- Vertaling van vertrouwelijke documenten. NL naar EN of vice versa, zonder cloud-tussenstap.
Wat je met een 7B-model niet moet proberen: complexe code-review, wiskundige analyses, of teksten waar één feitelijke fout tot juridische of financiële schade leidt. Human review blijft standaard.
AI-grenzen die je vast op tafel legt
Eerlijk over waar Ollama tekortschiet:
- 7B-modellen zijn duidelijk minder scherp dan GPT-4o of Claude Sonnet op complexe redenering, meerstaps-problemen en code-analyse. Verschil van 20 tot 40% op praktische taken is normaal, volgens publieke benchmarks op LMSys Chatbot Arena en Vellum LLM Leaderboard.
- Instructiebegrip in het Nederlands is goed voor kort werk, wisselvallig bij lange prompts of geneste instructies.
- Kennis is stale. Trainingsdatum ligt meestal 2023 of 2024 voor de 7B-familie; geen live-web-toegang zonder extra tooling.
- Hallucinaties blijven. Human review verplicht bij elke output die extern verspreid wordt.
- Geen ingebouwde AVG-garanties op wat je vraagt. Lokaal draaien betekent dat de data lokaal blijft, maar je bent zelf verantwoordelijk voor de kaders (wie mag inloggen, wat wordt gelogd, hoe lang bewaard).
Ollama-modellen komen onder verschillende open source-licenties (Apache 2.0, MIT, Llama Community License). Voor commercieel gebruik check je per model de voorwaarden op de Ollama library-pagina.
Kostenvergelijking indicatief
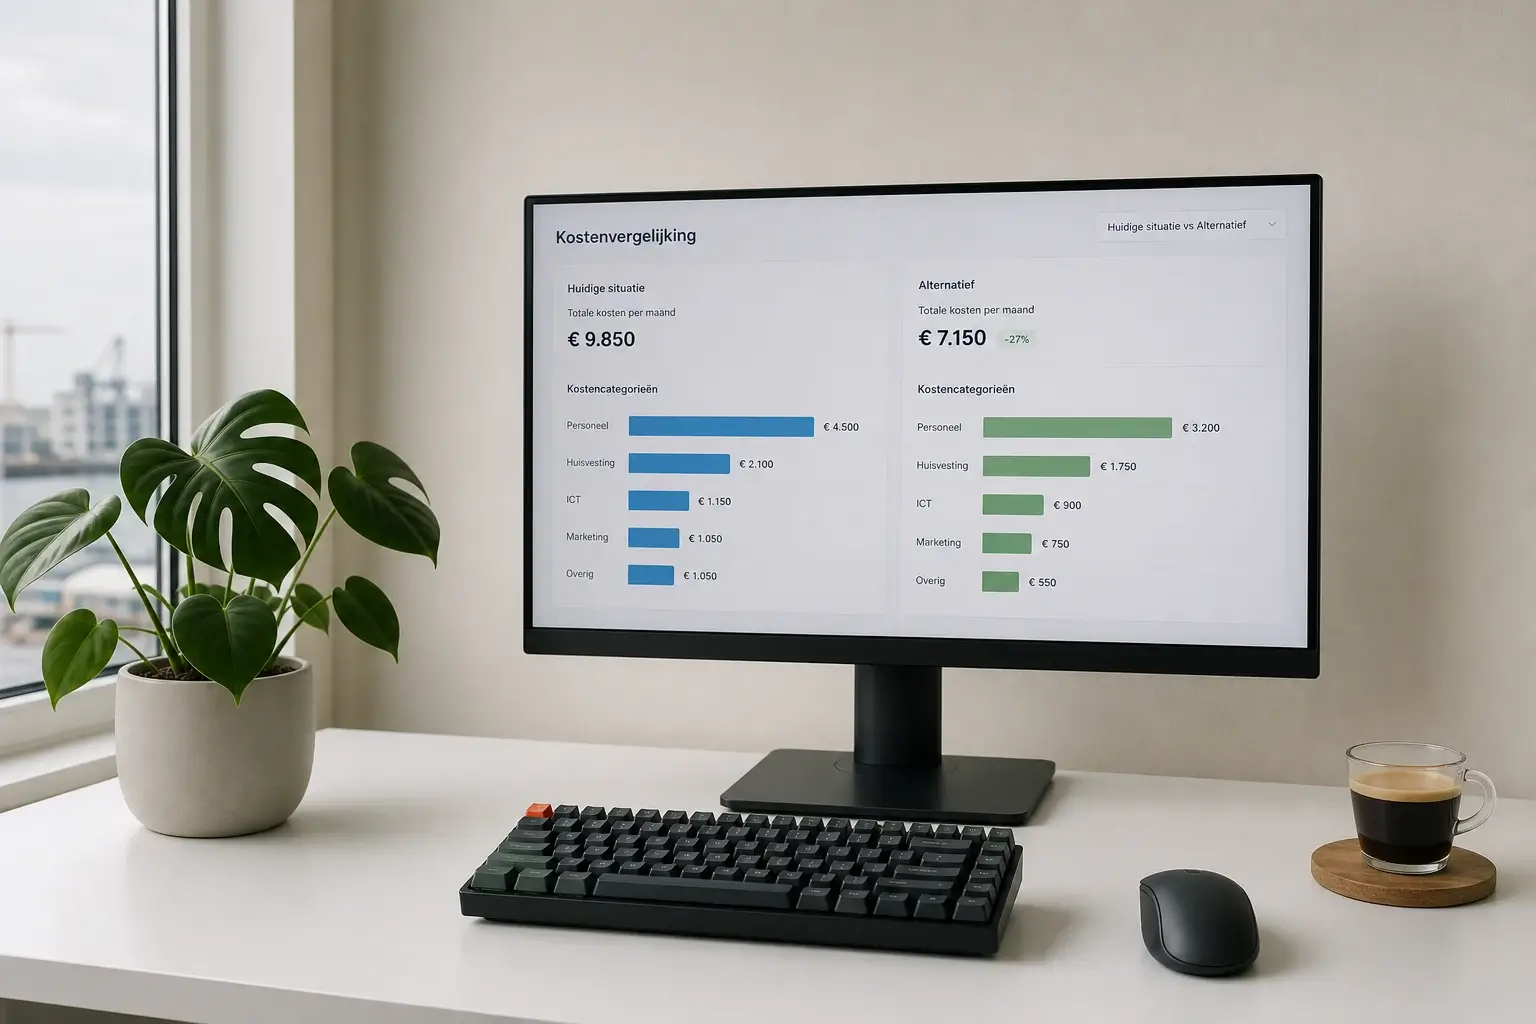
Ruwe rekensom voor een team van 10 gebruikers over 24 maanden:
- Ollama lokaal: eenmalig workstation €2.500, plus 8 uur setup à €70 = €560. Totaal 24 maanden: ~€3.100. Plus stroomverbruik ~€100/jaar.
- ChatGPT Team: 10 users × €25/maand × 24 = €6.000. Meer functionaliteit, cloud-afhankelijk.
- ChatGPT Enterprise: hogere kosten, hogere garanties (DPA, EU-hosting opties).
Break-even zit rond 6 tot 10 gebruikers of bij een hoge privacy-eis waarbij cloud-AI überhaupt geen optie is.
Wat de rekensom niet vangt: de tijd om lokaal te configureren, het minder-scherpe model, en het gebrek aan integraties (Slack-plug-ins, browser-extensies, mobiel gebruik). Voor teams waar productiviteit voorop staat is de cloud-optie vaak de betere ROI ondanks de hogere maandkosten.
Wanneer een DPO of IT-partner erbij
Ollama zelf is technisch geen juridisch product; wat je ermee doet wel. Drie situaties waarin je iemand met AVG-kennis erbij haalt:
- Bijzondere persoonsgegevens (zorg, financieel, strafrechtelijk): DPIA verplicht, ook bij lokaal draaien.
- Multi-user setup met logging: wat wordt gelogd, wie mag de logs zien, hoe lang bewaren.
- RAG-integratie met bestaande documentenopslag: als je Ollama laat rondkijken in SharePoint of Google Drive, herleeft de toegangs-rechten-discussie uit de cloud-wereld.
Voor de bredere AI-context binnen je Microsoft-stack zie Microsoft Copilot mkb; Ollama en Copilot sluiten elkaar niet uit maar dekken verschillende use cases. Voor de art 4-verplichting rond medewerker-training zie AI-geletterdheid art 4 mkb; lokale LLM-gebruikers vallen even hard onder art 4 als cloud-gebruikers.
Direct contact: hoe Lypii dit aanpakt
Een concrete Ollama-opstelling voor een klein team (2 tot 10 gebruikers) kost meestal 6 tot 12 uur. Dat is: use-case-intake, hardware-advies, installatie van Ollama plus Open WebUI, model-selectie en -test, een korte medewerker-instructie, en documentatie van de setup. Tarief: 95 euro per uur voor advies (model-keuze, use-case-scoring, AVG-check), 70 euro per uur voor uitvoering.
Wat ik niet doe: complete DPIA, juridische toetsing van je verwerkingen, of enterprise-scale RAG-implementaties met vector-databases voor honderdduizenden documenten. Dat is werk voor je DPO en een gespecialiseerde AI-consultancy.
Stuur me hoeveel gebruikers je wilt bedienen en welk soort documenten er langskomen. Ik reageer binnen 4 uur op werkdagen.